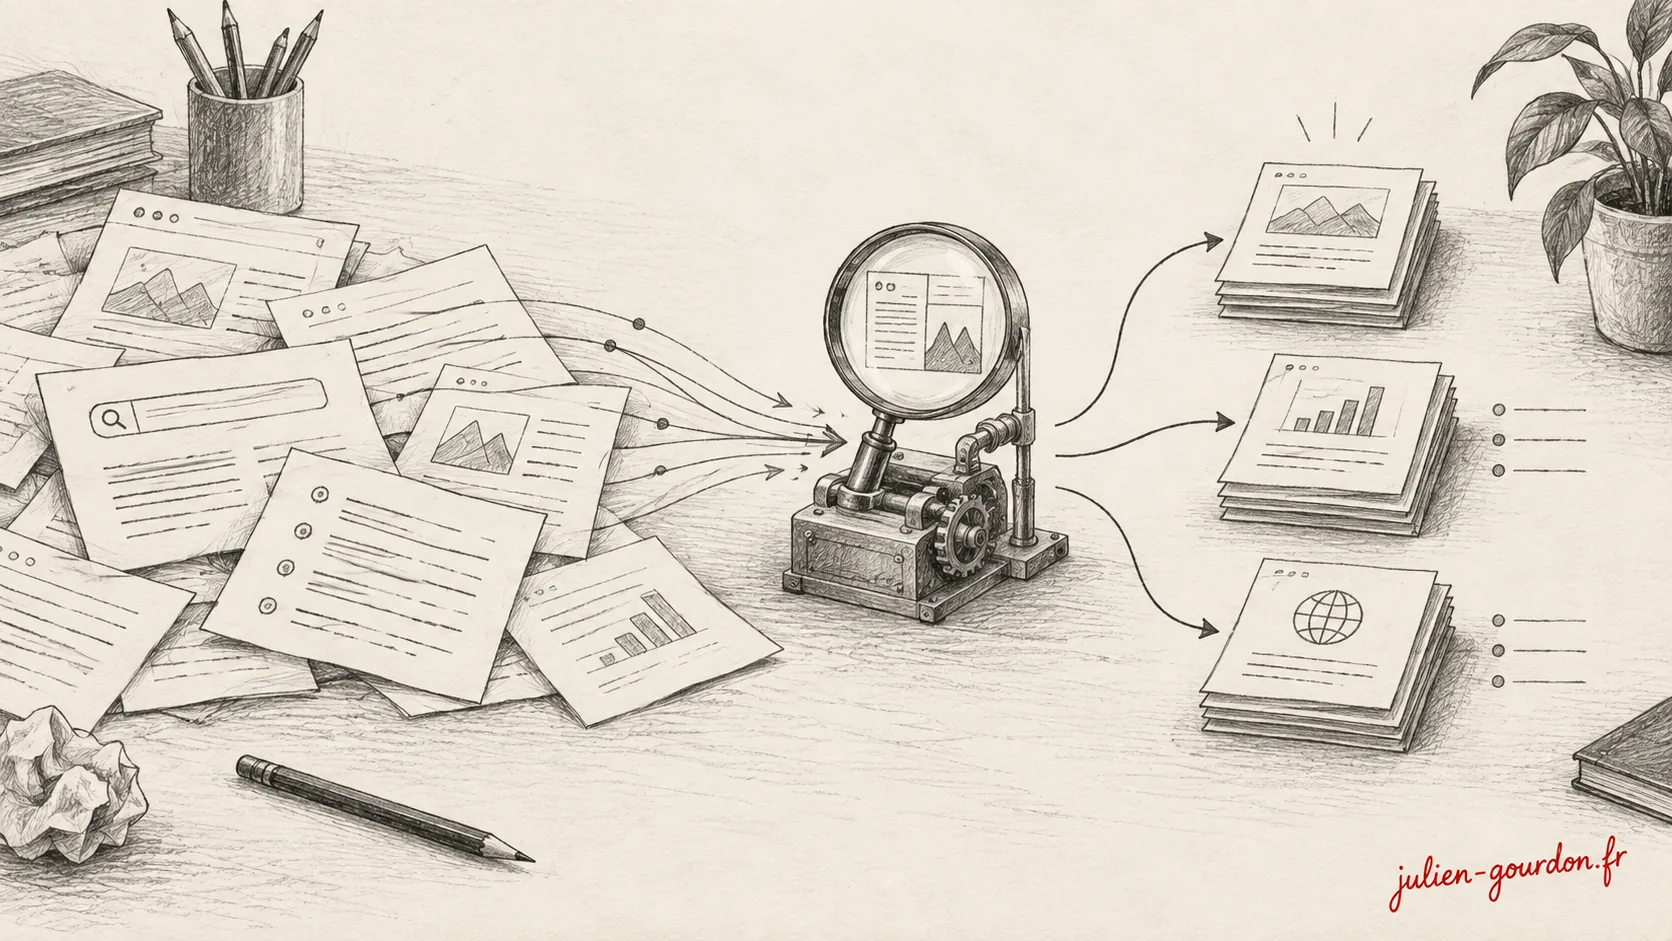
Jev est un modèle de décision de TypeSafe AI, lancé en accès anticipé le 15 septembre 2026 dans la catégorie « System One ». Il classe, évalue et choisit parmi des réponses définies, sans rédiger de texte libre. En SEO, je l’utilise déjà pour ma veille automatisée, la qualification de mots-clés et la hiérarchisation des questions dans AI Search Intent. Voici sept cas d’usage, leurs données d’entrée et leurs limites : une réponse structurée reste une appréciation à vérifier.
Qu’est-ce que Jev, le modèle « System One » de TypeSafe AI ?
Jev est un modèle d’intelligence artificielle développé et proposé par TypeSafe AI pour prendre des décisions structurées à partir d’informations textuelles. Son lancement public en accès anticipé date du 15 septembre 2026, selon l’annonce officielle de TypeSafe AI, signée par son fondateur Diogo Almeida, ancien chercheur chez OpenAI. On lui fournit un contexte et des questions dont les réponses possibles sont définies à l’avance.
TypeSafe appelle cette catégorie de modèles « System One », en référence au système de pensée rapide et intuitif popularisé par Daniel Kahneman. Il s’agit du vocabulaire choisi par l’entreprise pour désigner des jugements ciblés, directement utilisables dans un logiciel. Cette analogie décrit l’objectif du produit. Elle ne signifie pas que Jev reproduit la cognition humaine.
Quelle différence avec un LLM de génération de texte ?
Un LLM génératif peut rédiger un article, expliquer une recommandation ou produire du code. Il peut aussi classer des informations et renvoyer des données structurées. Jev se spécialise dans ce second type de travail : la documentation System One de TypeSafe précise qu’il ne rédige pas de réponses libres, de code ni d’explications de son raisonnement. Il renvoie des choix, des scores et des probabilités.
Pour un travail SEO, la répartition peut se lire ainsi :
| Besoin | LLM génératif | Jev |
|---|---|---|
| Proposer cinq titles | Rédige des formulations nouvelles | Peut évaluer des variantes déjà fournies |
| Analyser une intention | Peut expliquer son interprétation en texte | Choisit dans une grille d’intentions prédéfinie |
| Préparer un article | Développe un plan et rédige le contenu | Peut hiérarchiser des questions ou contrôler des critères précis |
| Renvoyer un résultat au logiciel | Texte ou sortie structurée selon l’interface | Valeurs contraintes par les options et niveaux fournis |
Cette spécialisation facilite l’intégration dans un processus automatisé. Elle ne rend pas chaque décision correcte. Jev peut sélectionner une mauvaise option parmi celles autorisées, et une réponse conforme au format peut reposer sur des données insuffisantes. Je conserve donc la collecte, les calculs et les règles d’action dans le code, avec une revue des cas incertains.
Dans mon travail de consultant, une part du temps passe à départager des options : quelle page répond à cette requête, quel lien apporte une information utile, quel titre promet trop par rapport au contenu ? Jev m’intéresse pour ces décisions répétées. La production du texte, la collecte des données et la mesure des résultats gardent leurs outils respectifs.
J’utilise Jev dans des outils accessibles sur ce site. J’ai aussi mené des pilotes sur des requêtes Search Console, des variantes de title et le choix de skills SEO dans mon environnement de travail. Ces essais m’ont appris à préciser la question avant de regarder le score. Un résultat rapide et bien formaté peut rester incertain, voire conduire à une mauvaise action si les données de départ sont insuffisantes.
Pourquoi plusieurs outils portent-ils le nom « Jev SEO » ?
« Jev SEO » recouvre les usages SEO du modèle Jev de TypeSafe AI, mais aussi plusieurs projets indépendants qui portent ce nom. Le Jev SEO d’Agrici Daniel produit des audits avec des rapports PDF, Excel et Markdown. Le jev-seo d’Akash Priyadarshi est une boîte à outils en Rust, accessible en ligne de commande et par MCP. Leurs dépôts, consultés le 27 septembre 2026, décrivent des produits distincts. Les exemples ci-dessous concernent l’utilisation du modèle dans un processus SEO, sans supposer l’installation de l’un de ces logiciels.
La documentation de TypeSafe AI distingue trois formes de questions. Choice sélectionne une option dans une liste. Score évalue une information selon des niveaux décrits. Noul estime la probabilité qu’une proposition soit vraie. Le code peut ensuite trier les réponses, appliquer un seuil ou envoyer les cas douteux en revue.
Pour choisir un premier usage, regardez la décision attendue et les informations que vous possédez déjà. Voici les principales possibilités, avec la limite à garder en tête.
| Cas d’usage SEO | Données à fournir | Décision attendue | Limite principale |
|---|---|---|---|
| Intention de recherche | Requête, contexte, résultats observés | Catégorie d’intention | Le texte de la requête peut être ambigu |
| Maillage interne | Passage source, pages candidates | Destination pertinente ou aucune | Un score ne justifie pas l’insertion du lien |
| Titles et meta descriptions | Page, requêtes, variantes | Classement selon des critères distincts | Le score ne prédit pas le taux de clic |
| Audit de contenu | Texte, brief, sources | Défauts à faire relire | La vérification dépend des preuves fournies |
| Veille et priorisation des pages | Actualités, contenus et données de performance | Sujets pertinents ou actions à examiner | Le score ne valide ni un fait ni une suppression |
| Questions prioritaires et couverture GEO | Questions de la SERP, passages, sources | Priorité éditoriale et niveau de couverture | La couverture ne prédit pas les citations IA |
| Routage du travail SEO | Demande résumée, compétences disponibles | Procédure ou modèle à mobiliser | Le choix reste à vérifier avant exécution |
1. Classer les mots-clés par intention de recherche
Jev peut préparer le classement d’un export de mots-clés dans des catégories définies à l’avance : information, navigation, comparaison, transaction et intention indéterminée. Ce tri aide à distinguer les requêtes qui appellent un guide de celles qui demandent une page de service ou un comparatif.
Il faut lui transmettre la requête et suffisamment de contexte. Pour « audit SEO », la formulation seule ne permet pas toujours de départager une recherche de méthode, d’outil ou de prestataire. Les résultats de recherche observés et la page actuellement associée donnent des indices supplémentaires. Une catégorie « indéterminée » évite de forcer une réponse.
Dans mon outil de recherche de mots-clés
Le mode IA de mon outil de recherche de mots-clés utilise déjà cette séparation des rôles. DeepSeek prépare des axes d’exploration à partir du thème. Google Ads fournit les idées et les estimations de volume. Jev qualifie ensuite chaque expression selon son intention, le besoin exprimé et sa pertinence pour le thème et le public indiqués.
Le besoin peut être de comprendre, apprendre à faire, résoudre un problème, comparer ou acheter. L’outil permet de filtrer les intentions et de trier selon la pertinence combinée à la confiance. Les idées incertaines ou écartées restent consultables et exportables, ce qui permet de revoir les décisions au lieu de perdre les mots-clés concernés.
Dans cette implémentation, l’intention et le besoin sont estimés à partir de la formulation de la requête. La pertinence utilise le contexte thématique fourni. Jev n’invente ni les volumes, ni une difficulté SEO, et ce classement ne remplace pas l’examen des résultats Google. La recherche classique reste distincte de ce mode enrichi par l’IA.
Ce que mon pilote Search Console m’a appris
J’ai réalisé un pilote sur 400 requêtes Search Console le 19 septembre 2026. Jev a évalué leur intention et leur adéquation avec les pages associées. Le protocole a signalé 278 cas à revoir. Ce nombre n’est pas un taux d’erreur : il rassemble les cas déclenchant nos critères de revue. L’échantillon était orienté vers des opportunités et ne représentait pas toutes les requêtes du site.
Autre réserve : les intentions de ce pilote ont été inférées sans vérification de la SERP. Je ne les présenterais donc pas comme des intentions confirmées. Pour un usage opérationnel, je ferais relire un échantillon annoté et vérifierais les résultats de recherche avant de créer ou de repositionner une page.
« À partir de cette requête et des résultats fournis, quelle intention domine : apprendre, comparer, acheter, retrouver un site précis ou indéterminée ? » Le résultat peut remplir une colonne de votre fichier de mots-clés. La création d’un contenu reste une décision ultérieure.
2. Sélectionner des liens internes utiles au lecteur
Jev peut comparer un passage source à une liste de pages candidates et estimer lesquelles apportent un complément pertinent. C’est une application intéressante lorsque vous avez déjà un inventaire fiable des contenus et que la proximité lexicale produit trop de suggestions faibles.
Je construirais ce parcours en deux temps. Un moteur de recherche interne ou une recherche vectorielle retient quelques destinations plausibles. Jev reçoit ensuite le passage à enrichir, les titres et des extraits des pages candidates. Il peut choisir une destination, attribuer des niveaux de pertinence ou répondre qu’aucune ne convient.
La question doit porter sur l’utilité du lien à cet endroit du texte. Deux pages qui parlent d’intelligence artificielle ne se complètent pas nécessairement. L’une peut définir un concept, l’autre vendre un service sans répondre à la question ouverte par le passage source.
Le reste relève du contrôle du site : vérifier les statuts HTTP, la langue, le canonical, les liens déjà présents et l’ancre envisagée. Dans un agent de maillage interne, je conserverais ces vérifications séparées du jugement sémantique. Jev ne devrait pas inventer une URL ni ajouter automatiquement des liens pour atteindre un quota. Je présente ici un parcours à évaluer, pas un gain de trafic mesuré sur mon site.
3. Comparer des titles sans confondre attrait et promesse tenue
Jev peut évaluer plusieurs propositions de title ou de meta description contre le contenu réel d’une page. L’intérêt est de séparer les critères : correspondance avec les requêtes, attrait de la formulation et fidélité à ce que le visiteur trouvera après le clic.
Un modèle génératif prépare les variantes. Le script vérifie les contraintes objectives, comme la longueur. Jev examine ensuite les dimensions sémantiques. Une formulation séduisante peut promettre un comparatif, un tarif ou une méthode que la page ne contient pas. La note de fidélité doit pouvoir empêcher sa sélection, même si elle paraît attractive.
J’ai testé ce processus le 25 septembre 2026 sur ma page de consultant SEO et GEO freelance, en comparant le title existant à cinq variantes avec un contexte issu de la page et de Search Console. La variante arrivée en tête ne franchissait pas tous les critères de confiance. Le titre existant a été conservé. Le pilote n’a entraîné aucun changement public.
Ce résultat me paraît plus utile qu’un score flatteur présenté comme une victoire. Nous n’avions ni test causal de taux de clic, ni vérification du titre effectivement affiché par Google. Un classement de propositions prépare une décision éditoriale. Pour savoir si la modification améliore le CTR, il faut ensuite suivre les performances dans des conditions comparables, en tenant compte des positions et du mélange de requêtes.
4. Repérer les faiblesses d’un contenu avant publication
Jev peut faire une première passe de contrôle éditorial à partir d’un brief précis. L’ouverture répond-elle à la question principale ? Le texte explique-t-il les termes nécessaires ? Une affirmation est-elle étayée par la source fournie ? Chacune de ces questions doit rester distincte.
Je préfère une grille qui désigne des défauts vérifiables à une note globale de « qualité SEO ». Pour un article visant « Jev SEO », l’ouverture doit par exemple expliquer les usages dans le référencement. Un long récit sur l’installation d’un routeur peut être exact et pourtant répondre trop tard au besoin du lecteur.
Pour les sources, TypeSafe propose un exemple de vérification des citations, consulté en septembre 2026. Il distingue la présence matérielle d’une citation dans le document et le fait que son contexte soutienne réellement l’affirmation. Le premier contrôle peut se faire dans le code. Le second appelle une appréciation sémantique.
Cette méthode peut signaler un passage à relire. Elle ne vérifie pas à elle seule que l’étude citée est fiable, récente ou applicable au marché français. Le résultat à transmettre au rédacteur devrait rester lié au passage et au critère évalué. La publication attend toujours le contrôle des faits et le jugement éditorial.
Une note de qualité devient utile lorsqu’elle aide à retrouver un défaut précis et à décider quoi relire. Un nombre isolé ne dit pas ce qu’il faut corriger.
5. Prioriser les sujets de veille et les pages à travailler
Sur ma veille SEO IA automatisée, Jev sert déjà à évaluer l’intérêt des contenus collectés pour des lecteurs qui travaillent sur le SEO et le GEO. Le système réunit des publications issues de médias spécialisés et de plateformes comme Reddit, YouTube, LinkedIn et X. La collecte et les résumés relèvent d’autres composants. Jev intervient sur la pertinence éditoriale.
Il reçoit notamment le titre, la source et les extraits disponibles. Sa grille distingue une actualité hors sujet, un lien périphérique avec l’IA et une information directement utile aux pratiques SEO ou GEO. Une annonce IA très populaire peut donc obtenir une faible pertinence si elle n’apporte rien de concret à ce public. Les cartes affichent un score de pertinence et un indice de confiance pour rendre cette appréciation visible.
Ces évaluations sont enregistrées et réutilisées : ouvrir la page ne déclenche pas un nouvel appel payant à Jev. Elles contribuent à la sélection éditoriale, sans garantir la véracité d’une actualité. Les liens vers les sources restent nécessaires pour vérifier une annonce et décider si elle mérite un approfondissement.
Étendre la revue aux contenus déjà publiés
Jev peut aider à organiser une revue de contenus en évaluant l’adéquation entre une page, ses requêtes et le rôle attendu sur le site. Les calculs de baisse de clics, de saisonnalité ou de conversion restent dans les outils de données. Le modèle intervient sur le sens du contenu et la nature de l’écart à examiner.
Pour départager plusieurs pages, je fournirais leurs extraits, les intentions visées et un dossier de performance comparable. Les catégories pourraient être « contenu à approfondir », « promesse à clarifier », « chevauchement à examiner », « données insuffisantes » ou « conserver ». Il s’agit d’une file de travail à relire, pas d’ordres de modification.
Sur la cannibalisation, deux pages proches sémantiquement ne suffisent pas à conclure. Il faut examiner les requêtes partagées, la stabilité des URL visibles et les intentions couvertes. Une fiche produit et un guide d’achat peuvent légitimement coexister. Jev peut signaler une ressemblance, mais les données de recherche et le contenu doivent confirmer le problème.
Une page peu cliquée peut servir les conversions, recevoir des liens ou répondre à une demande rare mais utile. Avant toute suppression ou fusion, vérifier son rôle, ses performances, ses liens et le plan de redirection. Les impressions seules ne prouvent ni une demande réelle ni l’inutilité d’un contenu.
6. Hiérarchiser les questions à couvrir en SEO et GEO
Dans mon outil AI Search Intent, Jev hiérarchise désormais les questions importantes identifiées à partir des contenus concurrents de la SERP. Il intervient après leur identification, pour apprécier leur utilité éditoriale au regard de la requête et du besoin du lecteur. Le but est d’aider à choisir les questions à traiter en priorité dans un brief ou un article.
L’évaluation s’appuie sur la requête, les questions et des extraits des pages analysées. Elle distingue leur pertinence, l’appui explicite dans les extraits et les doublons possibles. Le classement combine pertinence et confiance, puis répartit les questions entre « indispensables », « fortement recommandées », « valeur ajoutée » et « à examiner ». Les éléments incertains restent signalés pour revue.
Une question souvent répétée par les concurrents n’est pas nécessairement la plus utile. Inversement, un besoin pertinent peut être peu documenté dans les passages recueillis. Les extraits étant échantillonnés, l’absence de preuve dans cette sélection ne permet pas d’affirmer que tout le corpus concurrent ignore le sujet. Si l’évaluation Jev n’est pas disponible à temps, l’analyse conserve son classement de repli.
Utiliser ces questions pour examiner la couverture d’une page
Jev peut comparer des passages à un ensemble de questions que vos prospects posent aux moteurs génératifs. Le résultat attendu est une appréciation de couverture : réponse présente et étayée, réponse partielle, réponse absente ou informations insuffisantes.
Pour une offre de logiciel, les questions pourraient concerner la compatibilité, les limites, le prix ou la migration. Vous fournissez les passages concernés et des critères explicites. Le modèle peut aider à repérer les réponses qui dépendent d’un contexte absent, celles qui n’expliquent pas un terme ou celles qui avancent une affirmation sans preuve fournie.
La liste des questions doit elle-même avoir une origine défendable : échanges commerciaux, recherche de mots-clés, analyses d’intention ou questions réellement observées. Remplir une grille de centaines de questions inventées risque de produire beaucoup de scores et peu de décisions utiles.
Je traiterais cette approche comme un contrôle de contenu à expérimenter. Elle ne permet pas d’annoncer qu’une page sera citée par ChatGPT, Gemini ou Perplexity. La visibilité effective doit être observée séparément. Un score de couverture ou de citabilité reste dépendant de sa grille d’évaluation, sans équivalence démontrée avec une probabilité de citation.
7. Orienter une tâche SEO vers la bonne compétence
Jev peut aussi intervenir avant l’audit ou la rédaction, pour choisir une procédure dans un catalogue connu. C’est l’usage que nous avons construit autour de Codex : résumer une demande non sensible, consulter Jev, puis ouvrir les instructions de la skill retenue. Le contexte transmis reste limité, selon les principes du context engineering SEO.
Sur 12 cas synthétiques gelés de notre V4, le système a effectué 11 sélections automatiques correctes et une abstention, avec une latence médiane de 639 ms. Ce petit jeu de test ne prouve pas une fiabilité générale. Le déclenchement lui-même a nécessité des contrôles locaux, car une consigne écrite pouvait être ignorée par l’agent.
Le routeur peut également proposer un modèle pour une sous-tâche réellement utile à déléguer, parmi les modèles disponibles. Il ne change pas automatiquement le modèle principal et n’autorise pas une publication. Lors de la préparation de cet article, le résultat Jev n’a permis de sélectionner aucune skill : Codex a utilisé le repli prévu et choisi sa méthode localement.
Comment choisir un premier cas d’usage rentable ?
Je commencerais par le classement de requêtes ou la comparaison de titles, parce que leurs entrées et leurs sorties peuvent être relues sans modifier le site. Choisissez une décision que vous prenez souvent et préparez un jeu d’exemples annotés. Incluez des cas ambigus et des situations où la bonne réponse consiste à s’abstenir.
La documentation sur la confiance de TypeSafe explique que la confiance de Choice et Score est calculée à partir de leur distribution de probabilités. Dans mes pilotes, je l’utilise comme un signal de sélection, pas comme un pourcentage de bonnes réponses garanti. Les seuils doivent être évalués sur la tâche visée. Le français mérite aussi ses propres tests : TypeSafe indique que l’anglais reste la langue où Jev obtient actuellement ses meilleurs résultats.
Au 27 septembre 2026, le tarif public de Jev 1.13 est de 0,042 dollar par million de tokens d’entrée, avec les sorties gratuites. Dix mille décisions de 1 000 tokens d’entrée chacune représenteraient donc 0,42 dollar pour Jev seul. Ce calcul exclut les sources de données payantes, les autres modèles, le développement et la revue humaine. Un contexte plus long change directement le coût.
Gardez la collecte des données, les calculs et les contraintes techniques dans des composants vérifiables. Transmettez au modèle uniquement les informations nécessaires et autorisées. Enregistrez les décisions et leurs limites, puis mesurez le temps jusqu’au résultat validé plutôt que la vitesse d’un appel isolé.
Pour mon prochain pilote SEO, je privilégierais la réduction des faux positifs : moins de liens inutiles, moins de titles promettant trop, moins de pages classées à tort comme problématiques. C’est une manière concrète de juger l’apport de Jev, avant de lui confier davantage d’étapes.
Intégrer Jev à votre système SEO IA
Nous pouvons partir d’une tâche répétitive, de vos données et de critères vérifiables pour construire un pilote adapté à votre équipe.
Découvrir mon accompagnement SEO IA
Commentaires
Aucun commentaire pour le moment. Soyez le premier à commenter !
Ajouter un commentaire