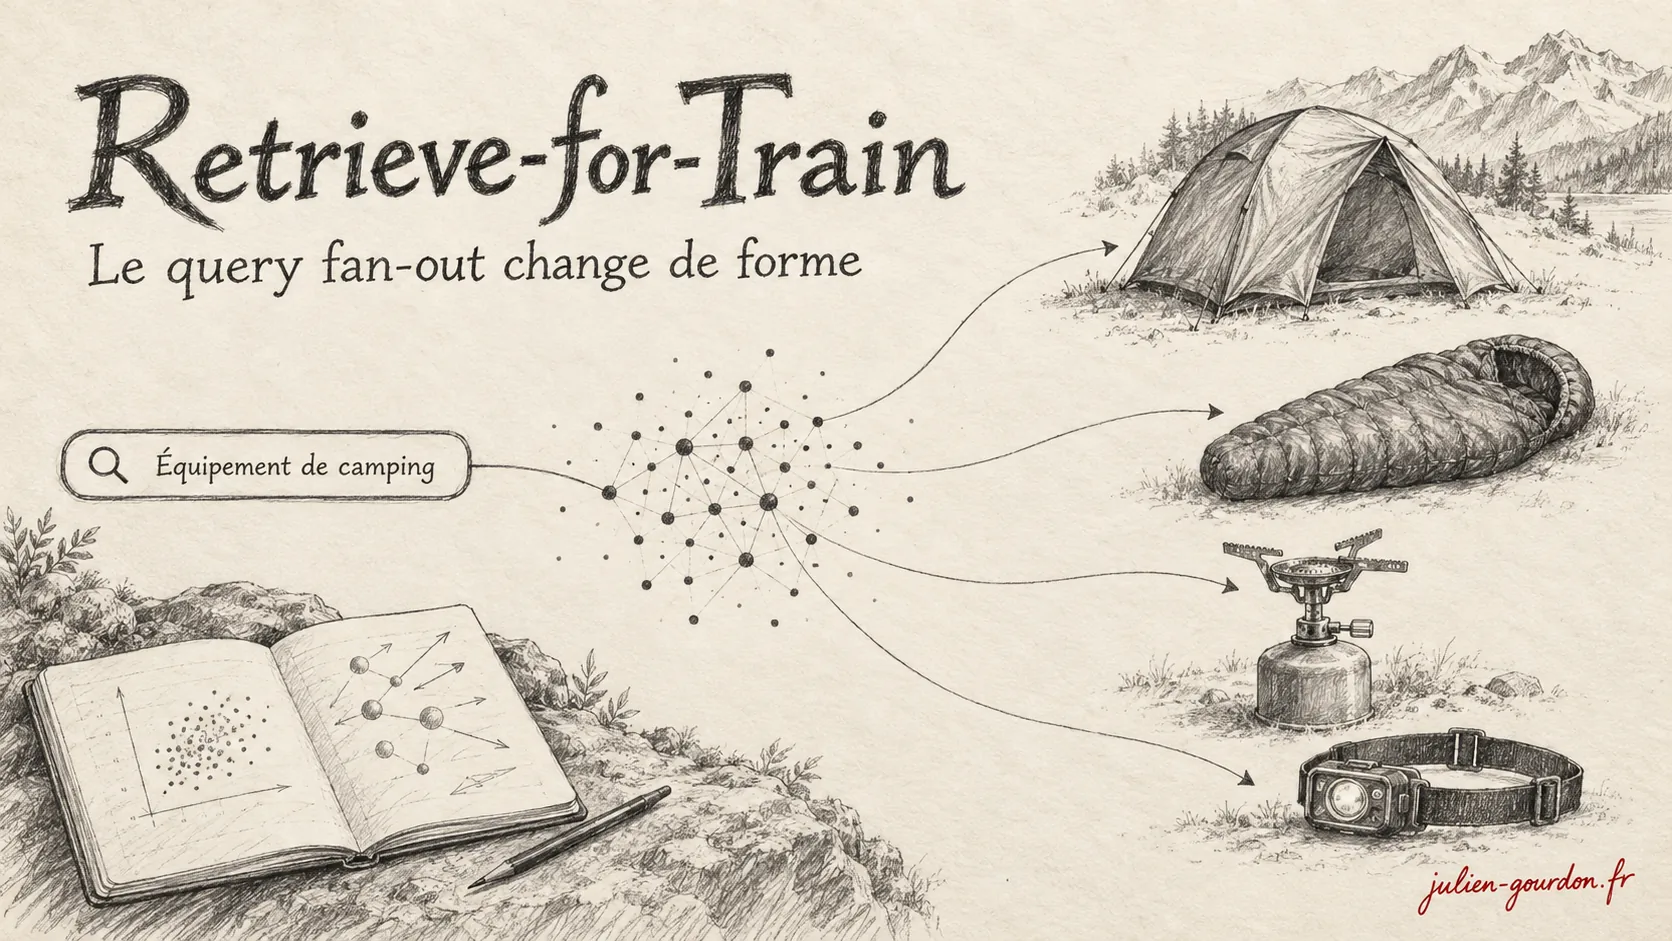
Retrieve-for-Train, ou R4T, est une méthode étudiée par des chercheurs de Google pour accélérer le query fan-out. Sa variante R4T-Diffusion apprend à un modèle léger à produire plusieurs directions de recherche complémentaires, sans rédiger des sous-requêtes à chaque utilisation. Les résultats sur des corpus de mode et de musique sont encourageants. Aucun déploiement dans Google Search n’est annoncé dans les publications étudiées. Pour le SEO, j’y vois surtout une raison supplémentaire de travailler la couverture des besoins plutôt que de poursuivre chaque formulation générée par une IA.
Vous préparez un week-end sous la tente. Vous demandez à un moteur de recherche de vous aider à choisir votre équipement, et il vous propose dix tentes. Certaines sont excellentes. Il vous manque toujours de quoi dormir au chaud et préparer le dîner.
Cet exemple, repris par Google Research dans sa présentation de Retrieve-for-Train, illustre une difficulté des moteurs IA : plusieurs résultats pertinents, pris séparément, peuvent former une réponse assez pauvre.
Le billet, publié le 15 septembre 2026, présente les travaux de Pengcheng Jiang et de ses coauteurs. Leur recherche m’intéresse pour une raison précise : elle permet d’envisager un fan-out dont les étapes ne prennent plus nécessairement la forme de requêtes lisibles.
Dix reformulations peuvent laisser le même besoin sans réponse
Le query fan-out sert à explorer plusieurs facettes d’une demande. Une question sur l’équipement de camping peut ainsi déclencher des recherches sur le couchage, la cuisine ou l’éclairage. J’en détaille le fonctionnement général dans mon article consacré au query fan-out.
Encore faut-il que ces recherches explorent des besoins différents. « Matériel de camping », « équipement pour camper » et « accessoires de camping » occupent trois lignes dans une liste. Elles peuvent pourtant ramener presque les mêmes produits.
Les chercheurs appellent ce comportement un effondrement paraphrastique. Le modèle reformule la demande au lieu d’en explorer les différentes composantes. Il donne l’impression de chercher davantage, avec un bénéfice limité pour l’utilisateur.
Pour notre campeur, une sélection utile devrait tenir compte des objets qui fonctionnent ensemble. Une excellente tente ne compense pas l’absence de sac de couchage. La qualité dépend donc aussi de la composition de la sélection, et pas uniquement de la pertinence de chaque objet.
Un modèle de langage peut réfléchir à cette complémentarité et préparer des recherches mieux ciblées. Mais cette réflexion demande du calcul. La génération du texte se fait progressivement, jeton après jeton. À grande échelle, ce temps s’accumule.
Les auteurs cherchent à conserver les bénéfices de cette préparation tout en réduisant son coût au moment où l’utilisateur attend sa réponse.
Le travail coûteux se fait pendant l’entraînement
R4T déplace l’apprentissage d’une bonne stratégie de recherche en amont de son utilisation. Dans le papier scientifique consacré à Retrieve-for-Train, la méthode comporte trois étapes.
Un modèle de langage apprend d’abord à produire de meilleures sous-requêtes. Il en propose, le système recherche les contenus correspondants dans une base, puis une fonction de récompense évalue le résultat. L’apprentissage par renforcement ajuste progressivement le modèle pour favoriser les comportements qui obtiennent les meilleurs scores.
Pensez à un vendeur qui s’entraîne à préparer des sélections à partir du catalogue de son magasin. Conseiller du matériel absent des rayons ne rendrait pas grand service au client. Recommander cinq articles presque identiques non plus.
Une fois entraîné, ce modèle sert à fabriquer des exemples : une demande de départ, accompagnée des cibles de recherche qu’il a appris à produire. Cette génération se déroule hors ligne. Aucun utilisateur n’attend devant sa barre de recherche pendant ce travail.
Ces exemples permettent ensuite d’entraîner un autre modèle, plus compact, fondé sur la diffusion. C’est lui qui prend en charge la recherche rapide dans la variante R4T-Diffusion.
Le premier modèle a donc un rôle de formateur. Il explore des stratégies coûteuses, dont le second apprend à reproduire les résultats utiles. Cette organisation exige un investissement initial. Son intérêt vient de la possibilité de réutiliser cet apprentissage sur de nombreuses demandes.
Comment récompenser une recherche utile ?
La récompense détermine ce que le modèle apprend à privilégier, avec des conséquences parfois inattendues.
Pour les recherches ouvertes, les auteurs combinent plusieurs critères. Le tableau suivant les traduit à partir de notre exemple de camping. Il s’agit d’une illustration pédagogique, pas d’un test mené sur ce secteur.
| Critère | Ce qu’il cherche à obtenir | Application à notre exemple |
|---|---|---|
| Ancrage dans la base | Des directions de recherche proches de contenus réellement récupérables | Retrouver du matériel présent dans le catalogue |
| Diversité | Des résultats suffisamment différents | Éviter une sélection composée uniquement de tentes similaires |
| Alignement avec la demande | Des recherches qui restent liées au besoin initial | Écarter des produits sans rapport avec le camping |
Ces critères se corrigent mutuellement. Récompenser uniquement la proximité avec la base peut conduire le modèle à produire des suites de mots incohérentes. Leur représentation numérique tombe au bon endroit et obtient un bon score, malgré leur manque de sens.
En ajoutant l’alignement avec la demande, un autre raccourci peut apparaître : répéter des variantes de la question initiale. Le modèle reste dans le sujet, mais la sélection manque de diversité.
Le score de Vendi intervient pour mesurer cette diversité à l’échelle de l’ensemble. Il aide à décourager les résultats trop semblables. Nul besoin d’en connaître la formule pour comprendre son rôle : une liste de dix propositions ne couvre pas nécessairement dix possibilités différentes.
Des directions de recherche à la place des phrases
R4T-Diffusion travaille avec des représentations numériques du contenu, appelées embeddings. Une image, un texte ou un morceau de musique peut être représenté par une liste de nombres. Selon le modèle employé, des contenus proches par leur sens ou leurs caractéristiques occupent des positions voisines dans cet espace.
Pour se le représenter, imaginons une carte. La demande de l’utilisateur indique une zone générale. Le moteur doit repérer plusieurs endroits intéressants à explorer autour de cette zone, tout en évitant de revenir au même point.
Un fan-out textuel exprimerait ces directions avec des phrases, comme « sac de couchage pour nuits fraîches ». Le modèle de diffusion apprend à produire directement des directions numériques. Une recherche de proximité permet ensuite de les associer aux contenus existants dans la base.
Les produits ou les documents ne sont donc pas inventés par la diffusion. Ils sont retrouvés dans un corpus. Et l’absence de sous-requêtes écrites concerne cette variante précise de R4T, au moment de son utilisation.
Au départ, ces directions contiennent une part d’aléatoire. Le modèle les ajuste progressivement en fonction de la demande, pour les rapprocher de zones utiles dans la base. C’est ce processus d’affinement que désigne ici la diffusion. Elle travaille sur plusieurs directions ensemble, au lieu de rédiger chaque recherche mot après mot.
Le billet Google emploie l’expression « une seule passe ». Je la nuancerais : l’annexe technique décrit un calcul de diffusion comportant 256 étapes. Il reste des calculs successifs. Le gain vient d’une autre manière de générer les directions de recherche, sans rédiger les sous-requêtes mot après mot.
Ce que mesure le gain de vitesse
Les auteurs annoncent une accélération d’environ 12 à 20 fois pour la génération du fan-out. Leur comparaison expérimentale des latences compare la diffusion à un modèle autorégressif, qui génère le texte jeton après jeton.
| Taille du lot traité | Modèle autorégressif | Modèle de diffusion |
|---|---|---|
| 8 requêtes | 1,46 seconde | 0,07 seconde |
| 1 024 requêtes | Près de 50 secondes | 4,21 secondes |
Ces valeurs mesurent le traitement de lots dans le protocole des chercheurs. Elles ne décrivent ni l’attente d’un internaute sur Google, ni le temps nécessaire pour produire une réponse complète avec ses sources.
Le modèle de diffusion compte 53,9 millions de paramètres. Sa taille et son mode de génération permettent ici de réduire fortement la latence. Il conserve aussi une partie des bénéfices du modèle entraîné par renforcement, sans le dépasser sur toutes les mesures de qualité.
J’éviterais donc le raccourci « Google répond vingt fois plus vite ». Les chiffres documentent un gain sur un composant expérimental. Ils sont déjà intéressants avec leur périmètre exact.
Une expérience sur la mode et la musique
Les expériences portent sur des corpus spécialisés. Les chercheurs utilisent Polyvore, un ensemble de tenues composées par des utilisateurs, et une base propriétaire de playlists musicales. Ils évaluent notamment la capacité à retrouver des ensembles diversifiés ou complémentaires.
Ce cadre diffère du Web, où les documents évoluent, disparaissent et se contredisent. Les auteurs reconnaissent eux-mêmes que le coût d’entraînement peut poser problème pour des bases très grandes ou fréquemment modifiées.
Une partie de l’évaluation repose aussi sur le jugement d’un modèle de langage. Cela apporte des indications, avec les biais possibles du modèle évaluateur. Les préférences humaines les plus subjectives restent difficiles à traduire en récompenses numériques.
Enfin, l’ancrage dans la base ne garantit pas la vérité d’une information. Retrouver fidèlement un contenu et vérifier son exactitude sont deux opérations distinctes.
À la lecture de ces publications, je ne peux pas affirmer que R4T est utilisé dans AI Mode. Elles n’annoncent aucun déploiement de ce type, en France ou ailleurs. Elles décrivent une piste de recherche dont les résultats justifient qu’on s’y intéresse, avec ces limites.
Ce que j’en retiens pour le SEO et le GEO
R4T me paraît surtout utile pour interroger notre manière d’aborder la couverture d’un sujet. La méthode illustre la possibilité d’explorer un besoin sans produire, à chaque recherche, une liste de phrases que nous pourrions observer puis cibler.
C’est une raison supplémentaire de rester prudent face à la course aux sous-requêtes. J’ai déjà expliqué pourquoi construire sa stratégie autour des formulations du fan-out me semble fragile. Cette recherche prolonge la réflexion, sans démontrer que les moteurs actuels fonctionnent tous ainsi.
Pour un site e-commerce consacré au camping, j’examinerais d’abord les situations réellement couvertes par les contenus. Préparer une nuit en famille près de sa voiture demande des conseils différents d’une randonnée de plusieurs jours. Le poids du matériel, la météo et la possibilité de cuisiner prennent une importance différente selon le séjour.
Cette lecture peut guider un travail éditorial concret :
- Vérifier qu’un guide aide à préparer le séjour entier, y compris les besoins moins visibles que le choix de la tente.
- Ajouter aux fiches produits les caractéristiques qui permettent de choisir, avec leurs conditions d’usage et leurs limites.
- Relier les contenus complémentaires lorsque le lecteur a besoin de poursuivre sa préparation.
Ces recommandations relèvent de mon analyse éditoriale. Le papier ne mesure aucun gain de position ou de citation lié à ces actions.
Je me garderais aussi de transformer la diversité en consigne de publication intensive. Une page supplémentaire se justifie lorsqu’elle répond à un besoin distinct. Changer quelques mots dans un titre pour couvrir une variante de requête apporte peu au lecteur.
Lors de votre prochaine révision de contenu, partez d’un cas précis : une personne doit prendre une décision avec votre page. Repérez ce qu’elle peut effectivement décider après l’avoir lue, puis ce qui lui manque encore. Ce manque vous donnera une piste de travail bien plus concrète qu’une nouvelle liste de reformulations.
Commentaires
Aucun commentaire pour le moment. Soyez le premier à commenter !
Ajouter un commentaire